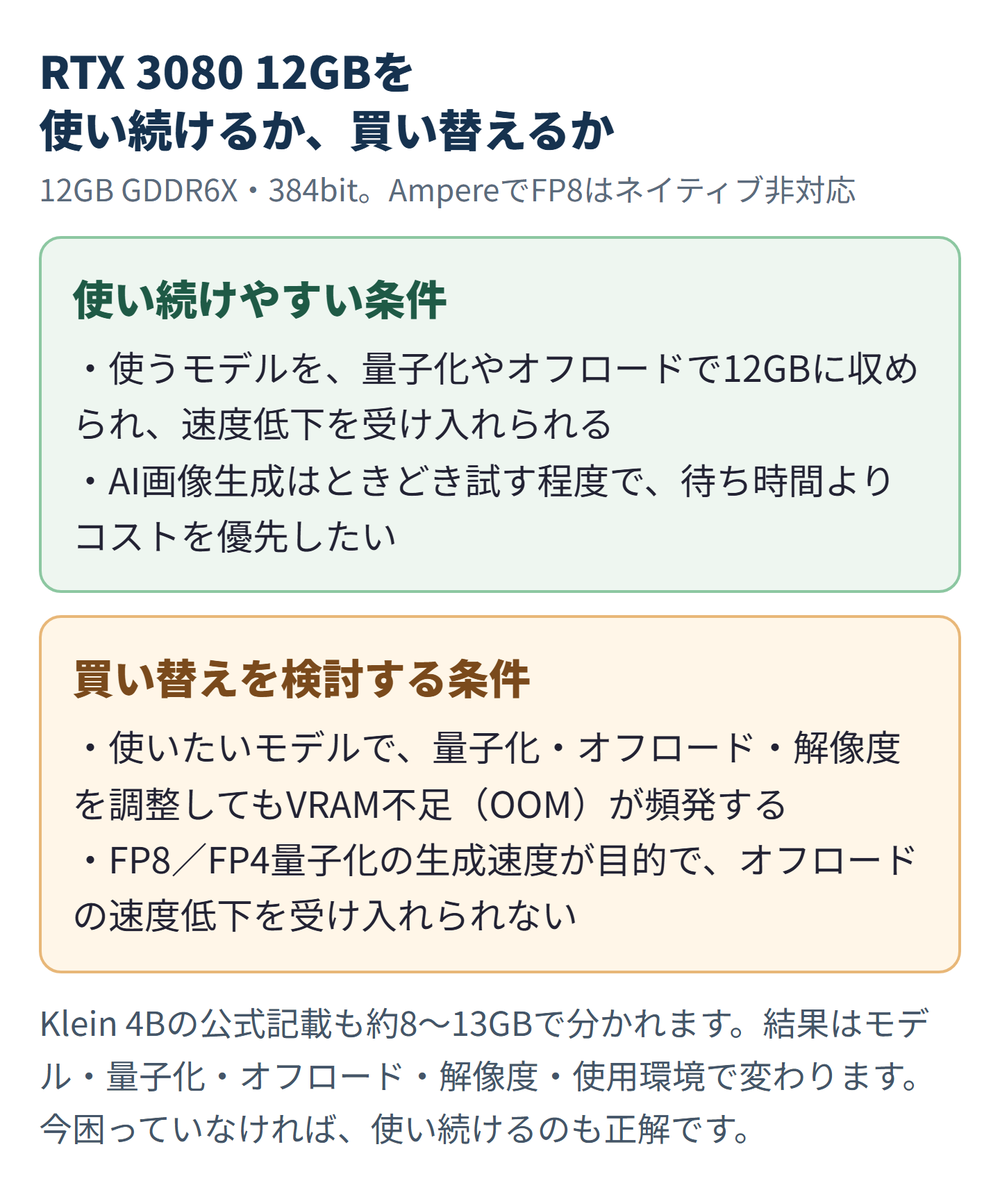
RTX 3080 12GBは発売から数年が経ちましたが、ラスタライズ性能自体はまだ十分という声も多いGPUです。一方でAI画像生成は、モデルが大きくなるほどVRAM容量とTensor Coreの世代(FP8のネイティブ演算に対応しているか)に結果が左右されます。この記事では、公式スペックとComfyUI・FLUX.2の公式情報をもとに、RTX 3080 12GBが「まだ使えるライン」と「買い替えを検討してよいライン」をどこで分けるかを整理します。
結論:RTX 3080 12GBはまだ使えるが「境界線上」にいる
RTX 3080 12GBは、2026年時点のAI画像生成(ComfyUI・FLUX.2系モデル)において、完全に力不足というわけではありませんが、最新世代のGPUに比べて2つの点で不利になっています。ひとつはVRAM容量そのもの、もうひとつはアーキテクチャ世代(Tensor CoreがFP8をネイティブに扱えるかどうか)です。
結論:RTX 3080 12GBで動くかどうかは、モデルの形式・量子化・オフロード・解像度・使用環境で変わります。公式のオフロード機能を使えば動かせる範囲は広がります。ただし「動かせる」と「快適に動く」は別で、FP8/FP4のネイティブ演算による高速化は世代的に使えません(FP8/FP4形式のモデルを読み込めるかは別の問題で、本記事では確認していません)。買い替えを検討してよいのは、量子化・オフロード・解像度を調整しても頻繁にVRAM不足(OOM)が起きる場合、または量子化による速度向上そのものが目的の場合です。
以下、まずRTX 3080 12GBの基本スペックとアーキテクチャ世代を確認し、そのうえでComfyUI・FLUX.2の公式情報と照らし合わせながら、実用範囲と買い替え境界を見ていきます。
RTX 3080 12GBの基本スペックとアーキテクチャ世代
RTX 3080には10GB版と12GB版の2つの構成があります。NVIDIA公式によれば、12GB版は384bitメモリバス・CUDAコア8960基・TDP350Wで、10GB版(320bitバス・CUDAコア8704基・TDP320W)より帯域幅・演算性能ともにわずかに高い構成です。いずれもAmpereアーキテクチャで、第2世代RT Core・第3世代Tensor Coreを採用しています。
| 項目 | RTX 3080(10GB) | RTX 3080(12GB) |
|---|---|---|
| メモリ容量 | 10GB GDDR6X | 12GB GDDR6X |
| メモリバス幅 | 320bit | 384bit |
| CUDAコア数 | 8704 | 8960 |
| 消費電力(TDP) | 320W | 350W |
| Tensor Core世代 | 第3世代(Ampere、FP8ネイティブ演算に非対応) | 第3世代(Ampere、FP8ネイティブ演算に非対応) |
注意:この記事は12GB版を主な対象にしますが、10GB版はVRAM容量がさらに少ない分、以降で説明する境界線に対しては12GB版より先に不足が出やすい点を踏まえて読んでください。
AI画像生成でVRAM 12GBが直面する境界(ComfyUI/FLUX.2)
FLUX.2 Klein 4Bの必要VRAMについて、Black Forest Labs公式は2つの異なる数値を出しています。公式ブログでは「約13GB VRAM、RTX 3090/4070以上」と明記していますが、同じBlack Forest Labs公式の製品ページでは「8.4GB」と記載されています。この記事ではどちらか一方を正解として断定せず、公式チャネル間で数値が食い違っている事実として両方を記録します。いずれもモデルの形式・量子化・オフロード設定・解像度などの測定条件は示されておらず、12GBで動作する・しないの保証ではありません。
注意:RTX 3080 12GBは、ブログ記載の推奨ライン(約13GB)には届きませんが、製品ページ記載の8.4GBには数値上収まります。どちらの数値が実態に近いかは本記事単独では確定できないため、実際に動かして判断するのが安全です。Klein 9Bは製品ページで19.6GBとされており、12GBでは明確に不足します。
さらに大きいFLUX.2 dev(32B)は、NVIDIA公式によるとフルロードに90GB、ComfyUIのlowVRAMモードでも64GBのVRAMが必要です。FP8量子化で約40%のVRAM削減が可能とされていますが、削減後の絶対GB数値は公式に示されていません。いずれにせよ90GBや64GBという水準は、RTX 3080 12GBはもちろん、現行の最上位コンシューマGPUでも単体では到達できない領域であり、後述のオフロード機能が前提になります。
VRAM不足を回避する公式の手段(Dynamic VRAM・オフロード)
ComfyUI公式は、VRAM不足に対する複数の緩和策を公式に提供しています。Dynamic VRAM(weight streaming)は、モデルの重みをオンデマンドでGPUへ流し込み、使用後に解放する仕組みで、NVIDIA製GPUならWindows/Linuxで利用できます。公式ブログでは、RTX 5060で合計56GB分のモデルを、システムRAM 32GBまたは64GBの構成で動作させた例が示されています。
- --lowvram:dynamic vram有効時は無効。無効時はtext encoderをCPUで実行
- --novram:lowvramでも足りない場合に使う、より強いオフロード
- --cpu-vae:VAE(画像デコード部分)をCPUで実行
- --reserve-vram:OS・他ソフト用に確保するVRAM量(GB)を指定
注意:これらのオフロード機能は「動かせる範囲を広げる」ものであり、速度を上げるものではありません。システムメモリはGPUメモリより低速なため、NVIDIA公式もオフロードには性能低下が伴うと明記しています。PyTorch公式ドキュメントが説明するメモリ断片化(empty_cache()やexpandable_segmentsで対策)も、VRAM不足のトラブルシューティングでは合わせて確認する価値があります。
アーキテクチャ世代の差:AmpereにはないFP8/FP4アクセラレーション
VRAM容量だけでなく、Tensor Coreの世代もAI画像生成の実用性に直結します。NVIDIA公式によれば、RTX 3080が属するAmpere(第3世代Tensor Core)はFP8をネイティブに演算する機能を持ちません。FP8 Transformer Engineは、Hopper(データセンター向け)とAda Lovelace(第4世代Tensor Core)で初めて導入された機能で、NVIDIA公式(GeForce Ada Lovelaceのページ)は、第4世代Tensor CoreのスループットがFP8 Transformer Engineの利用で最大5倍(1.4 Tensor-petaFLOPS)に上がると説明しています。これは理論上の最大値の表現で、画像生成の実際の速度が5倍になるという意味ではありません。
| 世代 | Tensor Core | ネイティブ演算に対応する形式(公式) |
|---|---|---|
| Ampere(RTX 30、RTX 3080含む) | 第3世代 | FP16/BF16/TF32/INT8/INT4(FP8ネイティブ非対応) |
| Ada Lovelace/Hopper(RTX 40等) | 第4世代 | 上記+FP8 Transformer Engine |
| Blackwell(RTX 50) | 第5世代 | 上記+FP4/FP6、第2世代FP8 Transformer Engine |
この差がどの程度実際の速度に影響するかについて、NVIDIA公式(Developer Blog)はFLUX.1-dev(30ステップ)の生成時間を比較しています。RTX 5090+FP4量子化では約3.85秒、RTX 4090(Ada世代)+FP8量子化では約10.62秒でした。量子化形式が異なるため単純な世代比較ではありませんが、新しいアーキテクチャほど量子化による高速化の余地が大きいという傾向は読み取れます。RTX 3080(Ampere)はこのFP8/FP4のネイティブ演算の土台自体を持たないため、この種の高速化は受けられません(FP8/FP4形式のモデルデータをAmpereで読み込めるか、VRAM削減が得られるかは、本記事では公式で確認できていません)。
ポイント:「VRAMが足りるか」と「量子化で速くなるか」は別の問題です。RTX 3080 12GBはVRAM容量の面ではモデルや設定次第で動かせる範囲がある一方、量子化アクセラレーションの面では最初から選択肢に入りません。速度を重視するならアーキテクチャ世代、動かせる範囲を広げたいならVRAM容量とオフロード機能、という優先順位の違いを意識してください。
買い替えを検討してよい境界
ここまでの内容を、買い替えを検討してよい条件と、そのまま使い続けてよい条件に整理します。
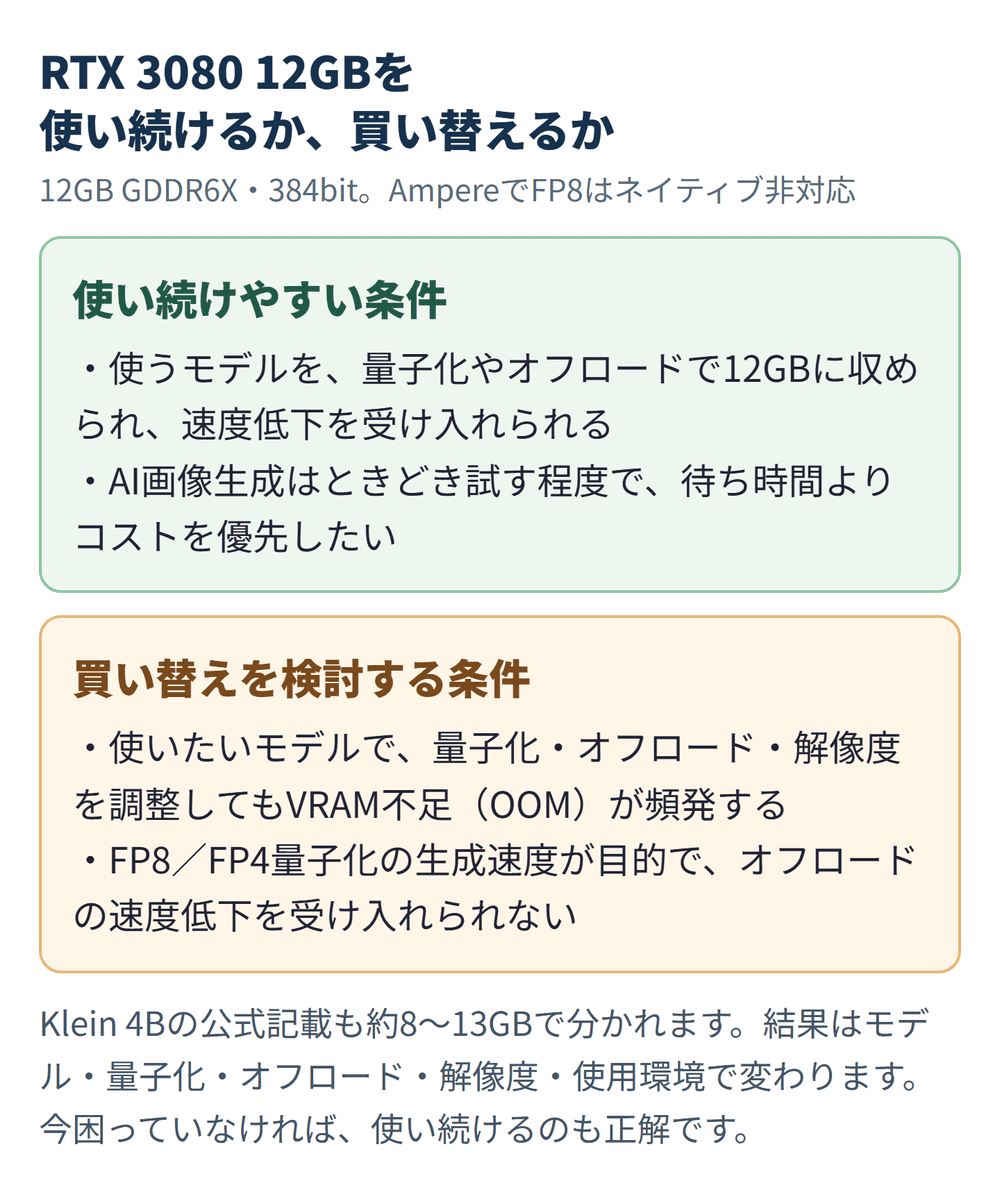
RTX 3080 12GBを使い続けるか買い替えるかの条件。結果はモデル・量子化・オフロード・解像度・使用環境で変わり、Klein 4Bの公式記載も約8〜13GBで分かれる。オフロードは「動かせる範囲を広げる」もので、速度を上げるものではない。(画像を拡大して見る)
- 買い替えを検討してよい:使いたいモデルで、量子化・オフロード・解像度を調整しても頻繁にVRAM不足(OOM)が起きる
- 買い替えを検討してよい:FP8/FP4量子化による生成速度そのものが目的で、オフロードによる速度低下を受け入れられない
- そのまま使ってよい:使うモデルを量子化やオフロードで12GBに収められ、多少の速度低下を受け入れられる
- そのまま使ってよい:AI画像生成はときどき試す程度で、待ち時間よりコストを優先したい
買い替え先を考える場合、同じ12GBのVRAM容量でもRTX 5070(NVIDIA公式、GDDR7 12GB)はAda以降の世代にあたり、FP8 Transformer Engineを備えます。VRAM容量を増やしたい場合は16GB以上のモデルが候補になりますが、型番ごとの詳細な速度比較には、この記事では踏み込みません。
| GPU | VRAM | 必要システム電力(NVIDIA公式) | グラフィックスカード電力(NVIDIA公式) |
|---|---|---|---|
| RTX 3080 12GB(今のGPU) | 12GB GDDR6X | 750W | 350W |
| RTX 5060 Ti 16GB | 16GB GDDR7 | 600W | 180W |
| RTX 5070 | 12GB GDDR7 | 650W | 250W |
| RTX 5070 Ti | 16GB GDDR7 | 750W | 300W |
VRAM容量を増やすことが目的なら、同じ12GBのRTX 5070ではなく、16GB版の候補(RTX 5060 Ti 16GB・RTX 5070 Ti)を見ることになります。必要システム電力はRTX 3080 12GBの750Wより小さい候補もあるため、電源を交換せずに済む可能性がありますが、この値はNVIDIAがRyzen 9 9950X構成を基準にした最小値で、実際に必要な容量はCPUやメーカー製カードの仕様で変わります。
注意:ゲーミング用途に限れば、RTX 3080(特に10GB版)は2026年時点でもラスタライズ性能自体は不足していないとされ、VRAM容量が1440p・4K高設定での制約になりやすいという評価にとどまります(Tom's Hardware、ゲーミング用途限定の評価)。AI画像生成での判断とゲーミングでの判断は評価軸が異なるため、混同しないようにしてください。
まとめ
RTX 3080 12GBで動くかどうかは、モデルの形式・量子化・オフロード・解像度・使用環境で変わります。公式のオフロード機能で動かせる範囲は広がりますが、FP8/FP4によるネイティブ高速化は世代的に持ちません。「動かない」のではなく「重い・遅い・工夫が要る」という境界線上にいるGPUだと捉えてください。
買い替えを検討してよいのは、量子化・オフロード・解像度を調整しても頻繁にVRAM不足が起きる場合と、量子化による高速化そのものが欲しい場合です。今の用途で困っていないなら、買い替えずに使い続けるという判断も十分に正解です。ComfyUIを動かすPCスペック全般については、ComfyUIが快適に動くPCスペックと推奨グラボの選び方も参考にしてください。
出典(公式情報)
この記事の数値は次の公式ページに基づきます(確認日:2026年10月11日。Tom's Hardwareの評価のみ2026年9月29日確認で、本文の再取得はできていません)。公式チャネル間で数値が違う項目は、本文のとおり併記しています。
・NVIDIA公式:GeForce RTX 3080 / 3080 Ti
・NVIDIA公式:GeForce RTX 5060ファミリー
・NVIDIA公式:GeForce RTX 5070ファミリー
・NVIDIA公式:Ada Lovelace アーキテクチャ
・NVIDIA Developer Blog:FP4画像生成(FLUX.1-dev、30ステップの比較表)
・NVIDIA公式ブログ:FLUX.2 on ComfyUI(dev=フル90GB・lowVRAM 64GB)
・Black Forest Labs公式:FLUX.2 Klein 製品ページ
・Black Forest Labs公式ブログ:FLUX.2 Klein
・ComfyUI公式ブログ:Dynamic VRAM in ComfyUI