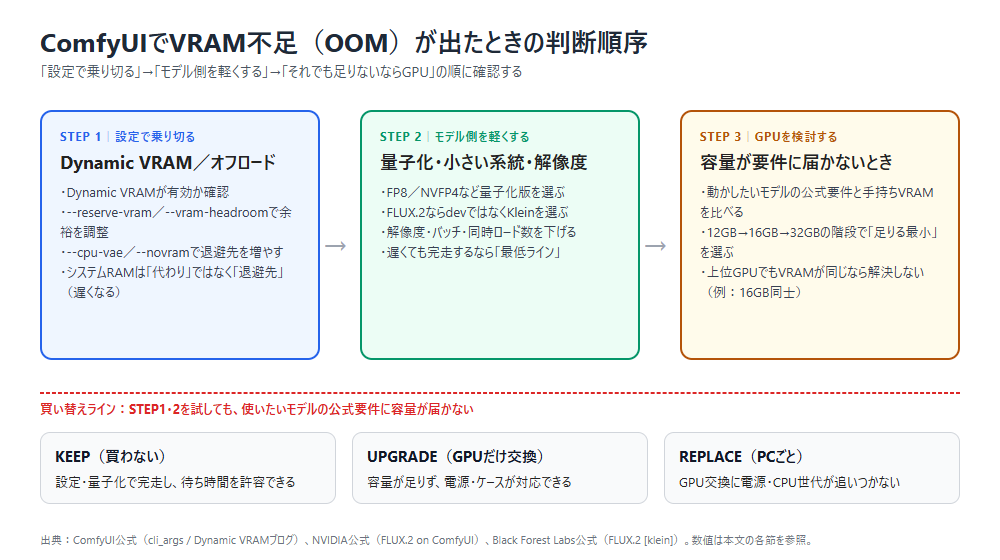
ComfyUIで「CUDA out of memory」が出ても、すぐにGPUを買い替える必要はありません。多くの場合は、設定(Dynamic VRAMやオフロード)とモデル側の軽量化(量子化・小さい系統・解像度)で完走できます。この記事では、OOMを「設定 → モデル → GPU」の順で潰す手順と、その順番を踏んでもなお足りない場合に初めてGPU購入を検討する「買い替えライン」を、公式情報だけを根拠に整理します。
結論:OOMは「設定 → モデル → GPU」の順に潰す。買い替えは最後
結論:VRAM不足(OOM)が出たら、(1) Dynamic VRAMとオフロード設定を確認し、(2) 量子化版や小さい系統のモデル・低い解像度へ切り替え、(3) それでも動かしたいモデルの公式要件に手持ちのVRAM容量が届かない場合だけGPUを検討します。「遅くても完走する」は最低ラインであり、実用・快適とは区別します。待ち時間を許容できるなら、買い替え(UPGRADE)は必須ではありません(KEEPで成立します)。
GPUのVRAMは「多いほど正解」ではなく、「動かしたいモデルの公式要件に足りているか」で決まります。逆に言えば、公式要件に届かない容量のGPUに買い替えても、OOMは解決しません。まず今のGPUで何ができるかを確かめ、買い替えは最後の手段として位置づけるのがこの記事の立場です。
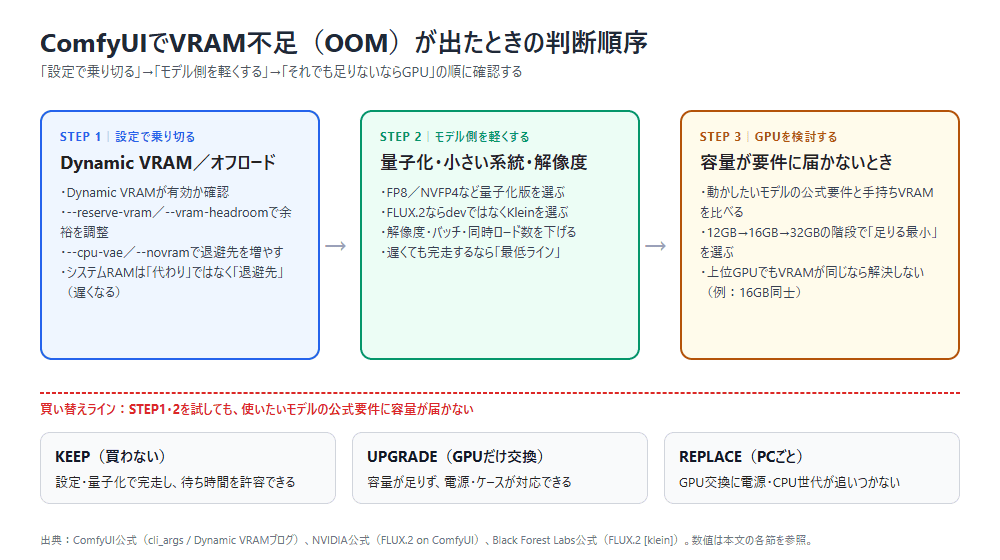
読み方:左から右へ順に試す。赤い点線より下(GPU検討)に進むのは、STEP1・2を試しても使いたいモデルの公式要件に容量が届かないときだけ。(画像を拡大して見る)
まずエラーの正体を知る:VRAM不足はPyTorchのメモリ割り当て失敗
ComfyUIはPyTorchの上で動いており、「CUDA out of memory」系のエラーはPyTorchがGPUメモリを割り当てられなかったときに発生します。PyTorchは高速化のためにキャッシュ型のメモリアロケータを使っており、一度確保したメモリを解放せずに保持します。
このため、nvidia-smiなどで見えるVRAM使用量には、PyTorchが確保済みで実際には使っていないキャッシュ分が含まれます。「使用率がほぼ100%なのに足りないはずがない」と感じる場面があるのはこのためで、表示上の使用量だけで買い替えを決めるのは早計です。PyTorch公式ドキュメントも、実際のテンソル使用量はmemory_allocated()などで確認するよう案内しています。
ポイント:nvidia-smiの数字は「PyTorchが握っている量」であって「今この瞬間に必要な量」ではありません。OOMの原因判断は、次のSTEP1・2を実際に試した結果で行います。
STEP 1:設定で乗り切る(Dynamic VRAMとオフロード)
最初に確認するのはComfyUI自体のメモリ管理設定です。現在のComfyUIには、必要なレイヤーの重みだけをその都度GPUへ載せる公式機能「Dynamic VRAM」と、テキストエンコーダやVAEをCPU側へ退避させる起動引数が用意されています。
Dynamic VRAMが効いているかを確認する
Dynamic VRAMは、ComfyUI公式ブログ(2026年3月)で解説されたPyTorch向けのカスタムVRAMアロケータで、モデルの重みをオンデマンドでGPUへ流し込む(weight streaming)仕組みです。公式ブログでは、RTX 5060で合計56GB分のモデルを、システムRAM 32GBまたは64GBの構成で動作させた例が示されています。詳細はComfyUI公式ブログ「Dynamic VRAM in ComfyUI」を参照してください。
注意:Dynamic VRAMの提供対象は公式ブログ時点でNVIDIA GPUのWindowsとLinuxです。WSL(Windows Subsystem for Linux)は対象外で、対応予定なしと明記されています。WSL上で運用している場合は、この機能に頼らずSTEP2以降で判断してください。
起動引数の定義(cli_args)には --enable-dynamic-vram と --disable-dynamic-vram があり、「既定で有効にならない環境で有効化する」「無効化して従来の見積もりベースのロードに戻す」ことができます。まず自分の環境でDynamic VRAMが有効になっているかを確認するのが第一歩です。
起動引数で退避先と余裕を調整する
ComfyUI公式リポジトリのcli_args.pyに定義されている、VRAM不足のときに関係する起動引数を整理します。説明文は公式定義の要旨です。
| 起動引数 | 公式定義の要旨(使いどころ) |
|---|---|
| --lowvram | Dynamic VRAM有効時は何もしない。無効時はテキストエンコーダをCPUで実行。使いどころ:Dynamic VRAMが無効な旧来構成のみ |
| --novram | lowvramで足りないときに使う(付けるとDynamic VRAMは既定で無効)。使いどころ:lowvramを試しても足りないとき |
| --cpu-vae | VAEをCPUで実行する。使いどころ:デコード段階でOOMになるとき |
| --reserve-vram | OSや他ソフト用に確保するVRAM量をGBで指定。使いどころ:画面表示やブラウザと共存させたいとき |
| --vram-headroom | Dynamic VRAMが空けておく余裕をGBで指定。使いどころ:他アプリのVRAM使用と競合するとき |
| --disable-smart-memory | モデルをVRAMに残さず積極的にRAMへ退避。使いどころ:連続実行で徐々に不足するとき |
見落としやすいのが --lowvram の扱いです。公式定義に「Dynamic VRAMが有効なら何もしない」とあるとおり、現在の既定環境では付けても挙動が変わりません。効かないと感じたら、Dynamic VRAM側の余裕(--vram-headroom)や退避先(--cpu-vae)を調整する方が筋が通ります。なお、非同期のweight offload(--async-offload)はNVIDIA GPUでは既定で有効です。
システムRAMは「代わり」ではなく「退避先」
オフロードやDynamic VRAMが機能すると、モデルの一部はシステムRAMに置かれ、GPUで扱える範囲が広がります。ただしNVIDIA公式ブログも明記しているとおり、システムメモリはGPUメモリより遅く、性能低下を伴います。「動くようになったが遅い」状態は、後述するライン(最低・実用・快適)の判断材料であって故障ではありません。
RAMを増設してもVRAMが増えるわけではありません。RAM増設は「退避先を広げて完走しやすくする」対策であり、速度面の解決にはならない点を切り分けて考えてください。
STEP 2:モデル側を軽くする(量子化・小さい系統・解像度)
設定を整えてもOOMが続く場合、次に見るのはモデル側です。同じ「FLUX.2」でも、系統と量子化の有無で公式の目安VRAMは大きく違います。ここではBlack Forest LabsとNVIDIAの公式記載だけを並べます。
| モデル | 公式記載のVRAM | 軽くする手段(公式記載) |
|---|---|---|
| FLUX.2 Klein 4B | 公式製品ページ 8.4GB/公式ブログ 約13GB(RTX 3090/4070以上)と記載が分かれる | FP8で最大約40%減、NVFP4で最大約55%減 |
| FLUX.2 Klein 9B | 公式製品ページ 19.6GB(ブログには数値なし) | FP8・NVFP4の量子化版あり(削減後のGB数は未提示) |
| FLUX.2 dev(32B) | フルロード 90GB、lowVRAMモードでも 64GB(NVIDIA公式) | FP8で約40%減(削減後のGB数は未提示) |
Klein 4Bの数値が公式チャネル間で一致していない点は重要です。製品ページは8.4GB、ブログは約13GBと記載しており、この記事ではどちらか一方を「最低ライン」と断定しません。8GBのGPUは、製品ページの8.4GBにも、ブログの約13GBにも容量が届きません。8GB環境で試す場合は、量子化やオフロードで必要なGPUメモリを減らせるかを確認し、量子化なし・オフロードなしで収まるとは考えないでください。出典はBlack Forest Labs公式 FLUX.2 Klein 製品ページ、Black Forest Labs公式ブログ、NVIDIA公式ブログ FLUX.2 on ComfyUIです。
モデルの系統や量子化を変えられない場合でも、次の3点は設定だけで試せます。数値の目安は環境依存のため、この記事では固定値を示しません。
- 生成解像度を下げる(同じモデルでも中間テンソルのサイズが小さくなる)
- バッチサイズを1にする
- 同じワークフローで同時にロードするモデル(複数のチェックポイント・アップスケーラ等)を減らす
判定の目安:STEP1・2で「遅いが完走する」なら最低ライン、量子化版でオフロードに頼らず完走するなら実用ラインです。快適ラインは、容量が足りるだけでなく、あなたが許容できる生成時間に収まることも条件です。いずれのラインでも、待ち時間を許容できればKEEP(買わない)で成立します。
STEP 3:それでも足りないときだけGPUを考える
GPU購入を検討するのは、STEP1・2を実際に試したうえで、動かしたいモデルの公式要件に手持ちのVRAM容量が構造的に届かない場合だけです。ここで大事なのは「上位GPU」ではなく「VRAM容量」で見ることです。
買い替えラインの定義
- Dynamic VRAMの有効化と起動引数(--cpu-vae / --vram-headroom など)を試した
- 量子化版(FP8・NVFP4)や小さい系統のモデルを試した
- 解像度・バッチ・同時ロード数を下げても、使いたいモデルが完走しない、または待ち時間が用途上許容できない
- 使いたいモデルの公式記載VRAMが、手持ちGPUのVRAM容量を明確に上回っている
4つすべてに当てはまる場合が、この記事で言う「買い替えライン」です。1つでも試していない項目があれば、まずそれを試すのが先です。
VRAMの階段:8GB → 12GB → 16GB → 32GB
NVIDIA公式仕様によるGeForce RTX 50シリーズ(デスクトップ)のVRAM容量は次のとおりです。買い替えるなら「足りる最小の段」を選ぶのが基本で、段が同じなら型番を上げても容量の問題は解決しません。
| VRAM容量 | 該当GPU(NVIDIA公式仕様) |
|---|---|
| 8GB | RTX 5060、RTX 5060 Ti(8GB版) |
| 12GB | RTX 5070 |
| 16GB | RTX 5060 Ti(16GB版)、RTX 5070 Ti、RTX 5080 |
| 32GB | RTX 5090 |
よくある誤解:RTX 5070 TiからRTX 5080へ上げてもVRAMは16GBのままです。OOMの原因が容量なら、この買い替えでは解決しません。同様に、16GB版と8GB版があるRTX 5060 Tiは購入時に容量を必ず確認してください。
最低・実用・快適・過剰ラインの考え方
この記事では、最低・実用・快適・過剰の4段階を「公式記載VRAMと手持ち容量の関係」で整理します。ベンチマーク由来の体感値ではなく、公式数値との比較で判断できるようにするためです。ただし快適ラインだけは、容量に加えて、あなた自身が許容できる生成時間(待ち時間)も条件に含めます。
| ライン | 定義 | 判断 |
|---|---|---|
| 最低ライン | STEP1・2(オフロード・量子化)を使えば完走する | KEEPで成立。待ち時間を許容できるか次第 |
| 実用ライン | 量子化版を使えばオフロードに頼らず完走する | KEEPで成立 |
| 快適ライン | 使いたい系統の公式記載VRAMを容量が上回り、量子化なしでも収まる。かつ、あなたが許容できる生成時間(待ち時間)で使える | 現状維持。上位化は不要 |
| 過剰ライン | 使う予定のない系統(例:dev 32B)の要件だけを理由に32GBへ上げる | 根拠のない上位化。避ける |
例えばFLUX.2 dev(32B)は、NVIDIA公式によればlowVRAMモードでも64GBを要するため、32GBのRTX 5090でもオフロードが前提になります。「devを快適に動かしたいから5090」という判断は、公式数値上は成り立ちません。逆にKlein 9B(製品ページ19.6GB)を量子化なしで収めたいなら、16GBでは公式数値に届かず、32GBが快適ラインに入ります。
KEEP・UPGRADE・REPLACE:あなたはどれか
最終判断は次の3択です。どれも「使いたいモデル」と「許容できる待ち時間」が決まって初めて選べます。
KEEP(買わない):STEP1・2で完走し、待ち時間を許容できる。VRAMが理由の買い替えは不要です。この記事のもっとも多い結論はここです。
UPGRADE(GPUだけ交換):買い替えラインの4項目に当てはまり、かつ今のPCの電源容量・ケースの物理クリアランス・電源コネクタが交換先GPUに対応できる。容量の段を「足りる最小」で選びます。
REPLACE(PCごと買い替え):GPUだけ交換したいが、電源・ケース・CPU世代が対応できず、複数パーツの交換費用がPC全体の買い替えに近づく場合。ここは費用比較が必要で、この記事では断定しません。
UPGRADEとREPLACEの境目(電源容量・物理互換・CPU世代の制約)は別記事で扱う予定です。ここでは「VRAM容量が原因かどうか」を切り分けるところまでを結論とします。
PCごと買い替える(REPLACE)と決めた場合や、UPGRADEで交換先の容量の段を決めたあとにGPU以外のパーツまで見直したい場合は、ComfyUIが快適に動くPCスペックと推奨グラボの選び方で、VRAM容量からGPUを選び、CPU・メモリ・SSD・電源を合わせる順番を整理しています。
NVIDIA以外のGPUでもComfyUIは動くが、Dynamic VRAMの対象は確認する
ComfyUI公式READMEには、AMD(ROCm)、Intel Arc(XPU)、Apple M系(Metal)での実行手順が記載されています。ただし、この記事で扱ったDynamic VRAMは公式ブログ時点でNVIDIA GPUのWindows/Linuxが対象です。NVIDIA以外の環境では、STEP1の一部(Dynamic VRAM)が使えない前提で、STEP2(モデル側の軽量化)を主軸に判断してください。
よくある質問
OOMまわりで特に多い4つの質問に、公式情報の範囲で答えます。
システムRAMを増やせばVRAM不足は解決しますか?
「完走するか」には効きますが、「速くなるか」には効きません。オフロード先としてのRAMは、GPUメモリより遅いため性能低下を伴うとNVIDIA公式が明記しています。完走できないケースではRAM増設が有効な場合があり、速度が問題ならVRAM側の話です。
--lowvramを付けても何も変わりません
公式の引数定義どおり、Dynamic VRAMが有効な環境では --lowvram は何もしません。--vram-headroom で余裕を増やす、--cpu-vae でVAEを退避する、--novram を試す、の順で確認してください。ただし公式のcli_args.pyでは、--novramや--highvram、--gpu-only、--cpuを付けるとDynamic VRAMは既定で無効になります(--enable-dynamic-vramを付ければ有効のままにできます)。Dynamic VRAMを活かしたいなら、--novramは最後の手段にしてください。
RTX 5070 TiからRTX 5080に替えればOOMは消えますか?
容量が原因なら消えません。NVIDIA公式仕様では両方とも16GBです。容量を増やしたいなら、次の段は32GB(RTX 5090)になります。ただし使いたいモデルが16GBに収まる系統なら、そもそも買い替えは不要です。
FLUX.2 Klein 4Bは8GBのGPUで動きますか?
公式製品ページは8.4GB、公式ブログは約13GB(RTX 3090/4070以上)と記載が分かれており、断定できません。8GBクラスで試すなら、FP8やNVFP4の量子化版(公式ブログで最大約40%・約55%減)とオフロードを併用し、実際に完走するかで判断してください。
買い替えラインに当てはまった場合の商品確認
PR:この先は楽天アフィリエイト広告を含みます
設定の見直しやモデルの軽量化を試しても足りず、上の買い替えラインに当てはまる場合だけ、交換候補の一例として型番と販売条件を確認してください。今のGPUで完走し、待ち時間も許容できるなら買い替えは不要です。購入前には、電源容量・コネクタ・ケース内の寸法と、使いたいモデルの条件を確認してください。

上の商品は16GB製品の一例です。掲載したこと自体が購入の必要性や、すべてのモデルでの動作・速度を保証するものではありません。販売条件や在庫は販売ページで確認してください。